Vectorizeとは?ベクトルデータベース入門
このページの目次16 items
前のページのRAGで、文章を「意味の座標」であるベクトルに変換し、質問に近いものを探すという考え方を見ました。
このとき必要になるのが、大量のベクトルを保存し、「近いもの」を高速に探し出せる保存先です。第6章で学んだD1やWorkers KVでは、この用途はうまく扱えません。数千次元の数値の並びを何万件も比較して、近い順に並べる――という処理は、専用の仕組みが必要だからです。
その専用の保存先がベクトルデータベースで、CloudflareではVectorizeがその役割を担います。
このページで分かること#
- ベクトルデータベースが普通のデータベースと何が違うのか
- インデックス・次元数・距離の測り方という3つの基本概念
- メタデータと名前空間による絞り込み
- Workers AIと組み合わせた使い方
- 料金の考え方(「次元」という独特な単位)と制限
ベクトルデータベースとは#
普通のデータベースは「完全に一致するもの」を探します。
SELECT * FROM articles WHERE title = '有給休暇について';これは、タイトルがこの文字列と1文字も違わない行だけを返します。「年次有給の付与日数」という記事は見つかりません。
ベクトルデータベースが探すのは「近いもの」です。
このベクトルに近いものを、上位5件ください数値の座標として近い=意味として近い、というのがベクトルの性質でした。ですからこの問い合わせは、実質的に「意味が近い文章を5件ください」という意味になります。
Vectorizeは2026年4月に正式提供(GA)となり、実験段階のサービスではなくなっています。
3つの基本概念#
インデックス#
Vectorizeにおける「入れ物」の単位です。第6章のD1でいうデータベース、R2でいうバケットにあたります。ベクトルはインデックスの中に入れ、検索もインデックス単位で行います。
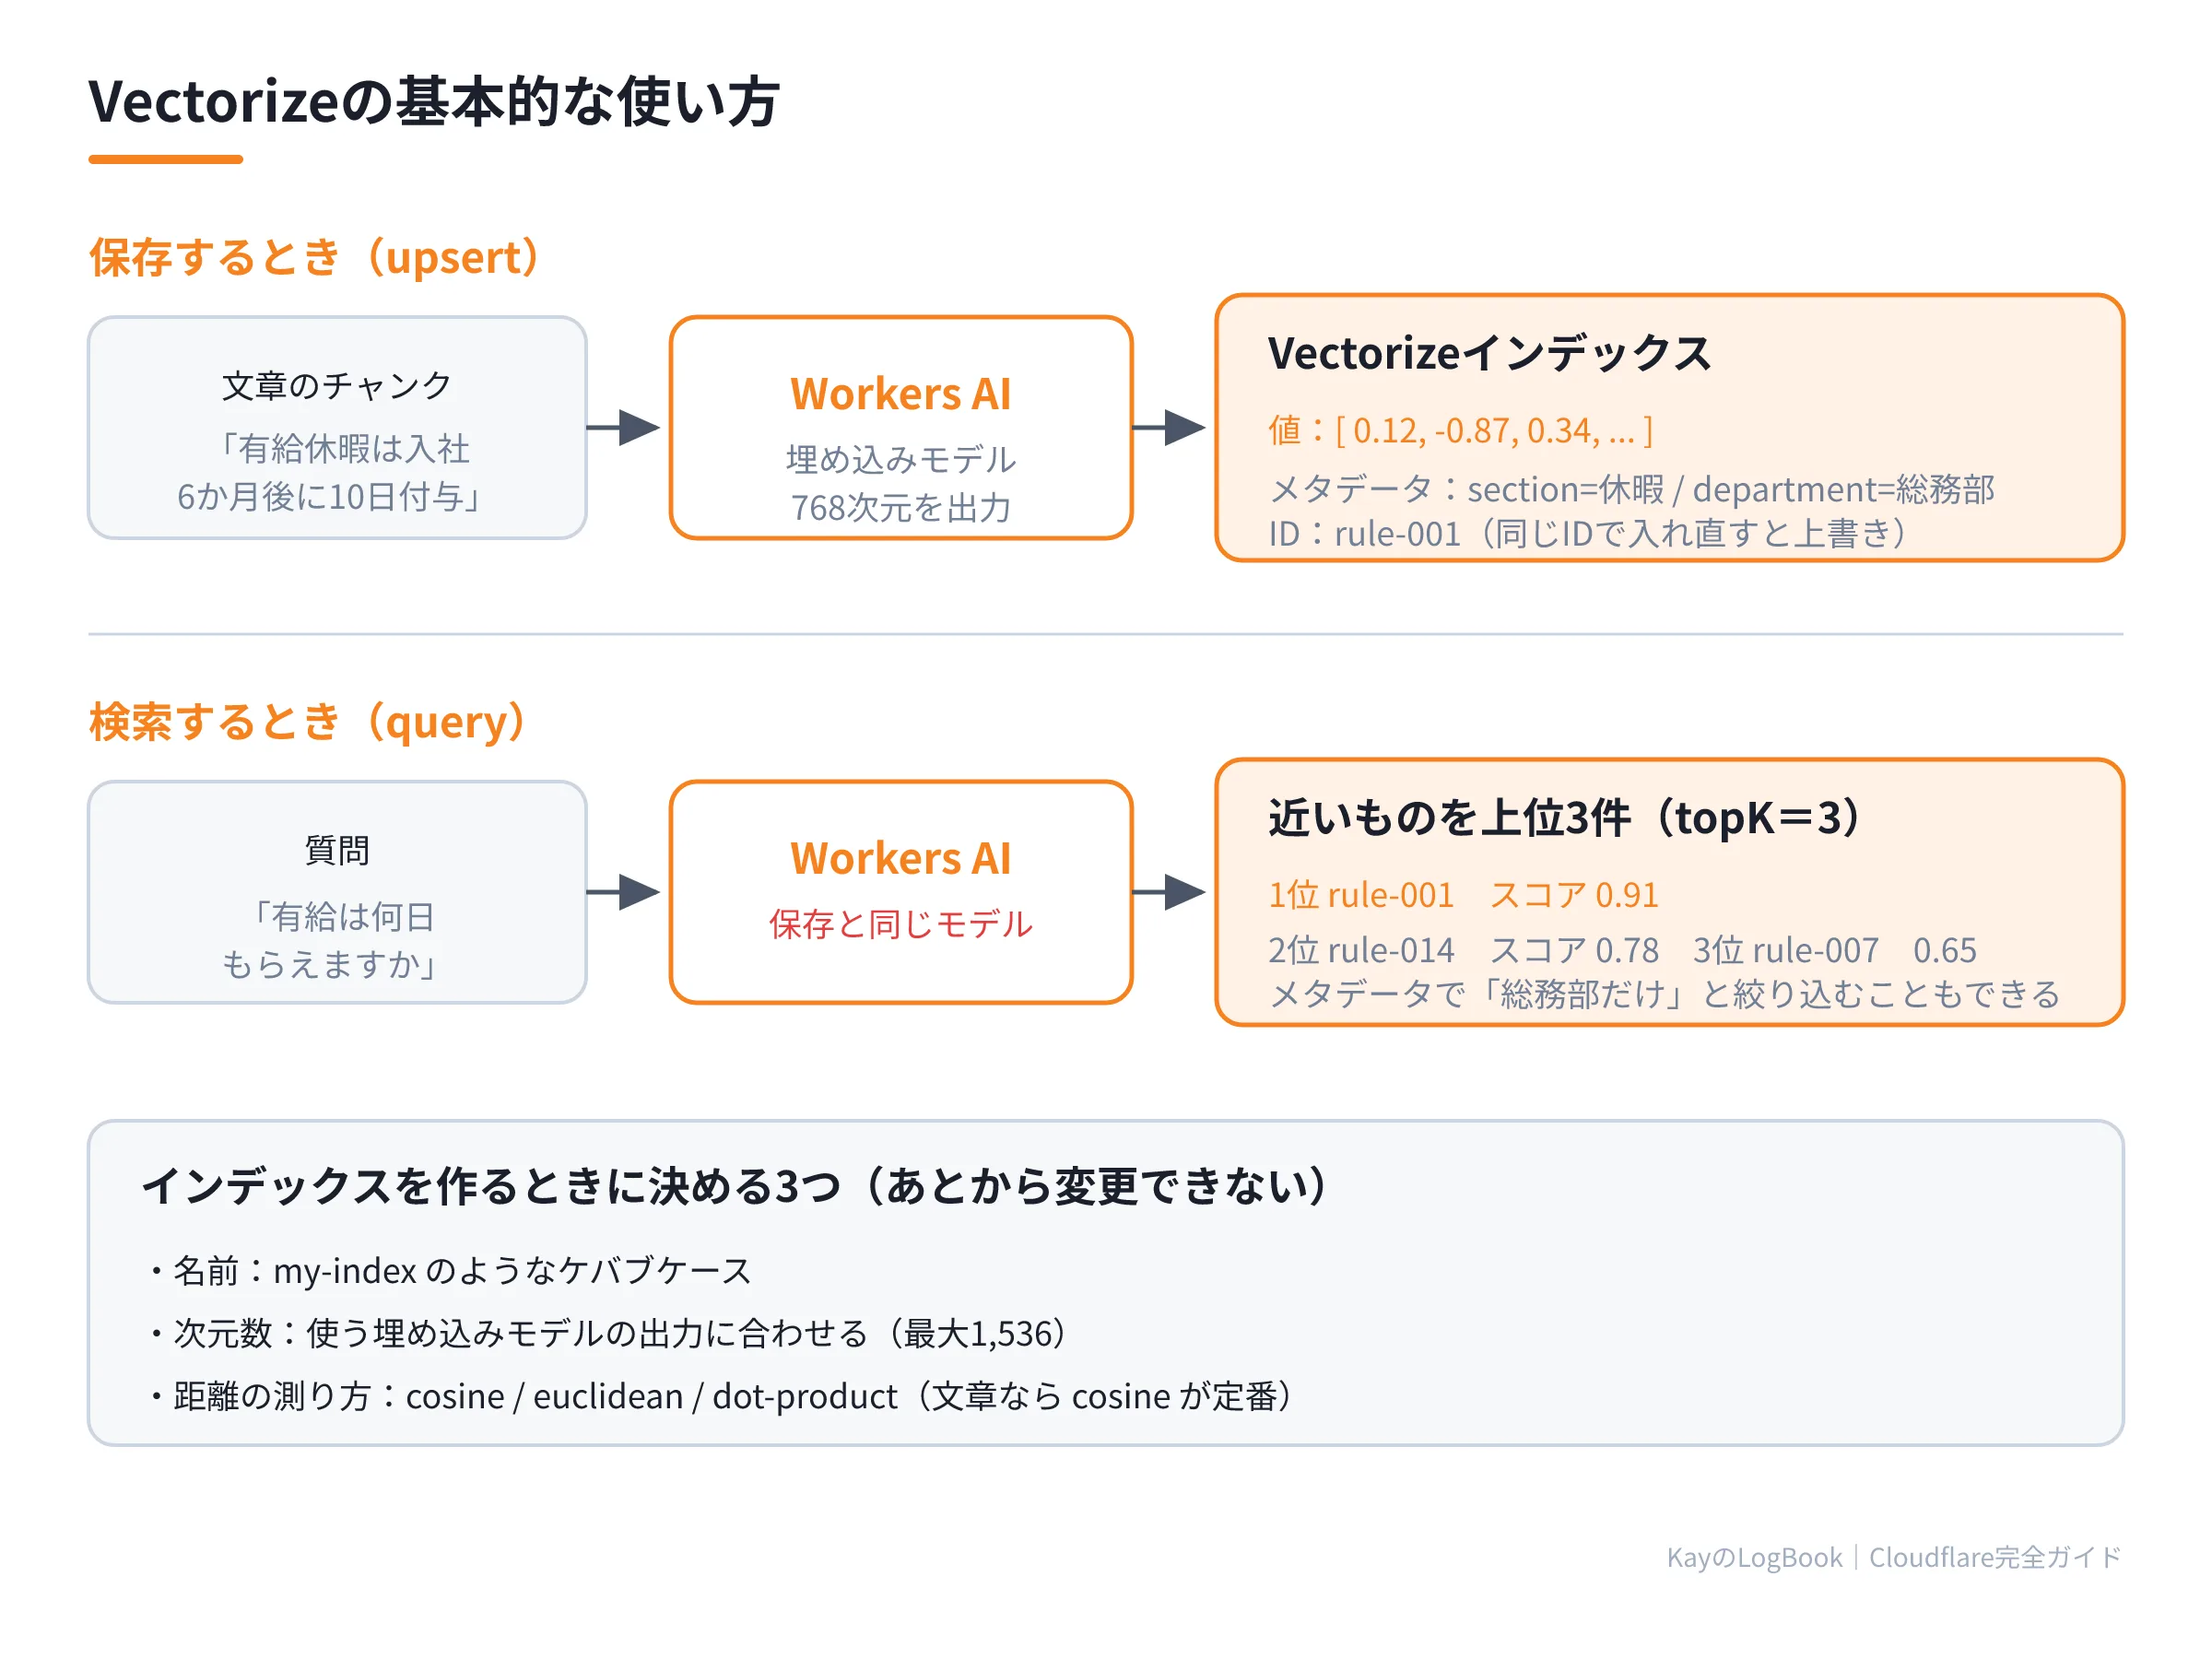
インデックスを作るときに決めるのは3つです。
npx wrangler vectorize create my-index --dimensions=768 --metric=cosine- 名前:
my-indexのようなケバブケース(小文字とハイフン)の名前 - 次元数:1つのベクトルに含まれる数値の個数
- 距離の測り方:近さをどう計算するか
重要なのは、次元数と距離の測り方は、作成後に変更できないということです。変えたい場合はインデックスを作り直し、すべてのベクトルを入れ直すことになります。
次元数#
ベクトルに含まれる数値の個数です。この数は自分で決めるのではなく、使う埋め込みモデルによって決まります。
| 埋め込みモデル | 出力される次元数 |
|---|---|
| Workers AI の bge-base-en-v1.5 | 768 |
| OpenAI の ada-002 | 1536 |
| Cohere の embed-multilingual-v2.0 | 768 |
| Google Cloud の multimodalembedding | 1408 |
インデックスの次元数は、使う埋め込みモデルの出力に合わせる必要があります。768次元のモデルを使うなら、インデックスも768次元で作ります。
次元数が大きいほど、文章の細かい違いまで表現できるため精度は上がる傾向があります。一方で、保存する容量も検索の負荷も比例して増え、料金にも直結します。Vectorizeで扱える上限は1,536次元です。
距離の測り方(距離メトリック)#
「近い」をどう計算するかの方式です。3種類あります。
| 方式 | 特徴 |
|---|---|
cosine |
-1(最も似ていない)から1(同一)で表す。0は無関係。文章の類似度検索で最もよく使う |
euclidean |
座標間の直線距離。0が同一で、大きいほど遠い |
dot-product |
内積の符号を反転したもの。値が小さい(大きな負の数)ほど似ている |
迷ったら cosine を選んでください。文章の埋め込みでは事実上の標準です。使う埋め込みモデルの説明に推奨のメトリックが書かれている場合は、それに従います。
メタデータと名前空間#
ベクトルには、数値の並びだけでなくメタデータ(付随する情報)を一緒に保存できます。
await env.VECTORIZE.upsert([
  {
    id: "doc-123-chunk-4",
    values: [0.12, -0.87, 0.34, /* ... 768個 */],
    metadata: {
      title: "就業規則",
      section: "第5章 休暇",
      updated: "2026-04-01",
      department: "総務部",
    },
  },
]);
このメタデータは、検索時に2つの役割を果たします。
1つめは絞り込みです。「総務部の文書だけを対象に、近いものを探す」といった条件を付けられます。RAGで権限管理を実現するときの基本手段になります。
**2つめは出典の表示です。**検索結果と一緒にメタデータも返るため、「就業規則 第5章より」と利用者に示せます。
名前空間(namespace)は、インデックスの中をさらに区切る仕組みです。利用者ごと、テナントごとにデータを分けたいときに使います。名前空間を指定して検索すれば、他の名前空間のベクトルは絶対に返りません。メタデータでの絞り込みより明確な分離ができます。
Workers AIと組み合わせて使う#
Vectorize単体では何もできません。ベクトルを作るのはWorkers AIなどの埋め込みモデルの仕事です。実際のコードは、次のような形になります。
保存するとき
// 1. 文章をベクトルに変換する
const { data } = await env.AI.run("@cf/baai/bge-base-en-v1.5", {
  text: ["有給休暇は入社6か月後に10日付与されます"],
});

// 2. Vectorizeに保存する
await env.VECTORIZE.upsert([
  { id: "rule-001", values: data[0], metadata: { section: "休暇" } },
]);
検索するとき
// 1. 質問を同じモデルでベクトルに変換する
const { data } = await env.AI.run("@cf/baai/bge-base-en-v1.5", {
  text: ["有給は何日もらえますか"],
});

// 2. 近いものを上位3件取り出す
const results = await env.VECTORIZE.query(data[0], { topK: 3 });
upsert は「なければ追加、あれば更新」を行う操作です。同じIDで入れ直せば内容が置き換わるため、文書の更新時に削除と追加を分けて考える必要がありません。
topK は取り出す件数です。値やメタデータも一緒に受け取る場合は最大50件、IDとスコアだけなら最大100件まで指定できます。
RAG以外の使いどころ#
ベクトル検索はRAGのための技術と思われがちですが、用途はもっと広くあります。
- 類似記事の推薦:読んでいる記事のベクトルに近い記事を出す
- 重複・類似の検出:似た問い合わせが既に来ていないかを調べる
- 画像検索:画像を埋め込みモデルに通せば、「似た画像」を探せる
- 分類:あらかじめ分類ごとの代表ベクトルを置き、最も近いものに振り分ける
- 異常検知:普段のパターンから遠いものを見つける
いずれも「完全一致では見つけられないものを探す」という共通点があります。
料金#
Vectorizeの料金は「次元」という単位で計算されます。ベクトルの本数ではなく、次元数を掛けた総量で数えるところが独特です。
| 項目 | Workers無料プラン | Workers有料プラン |
|---|---|---|
| クエリ次元 | 月3,000万次元まで | 月5,000万次元まで込み、超過分は100万次元あたり0.01ドル |
| 保存次元 | 500万次元まで | 1,000万次元まで込み、超過分は1億次元あたり0.05ドル |
保存次元は分かりやすく、ベクトルの本数 × 次元数 です。768次元のベクトルを10,000本入れると、768万次元になります。
クエリ次元は少し独特で、(月間のクエリ回数 + 保存しているベクトルの本数) × 次元数 で計算されます。保存しているベクトルの本数がそのまま加算される点に注意してください。データが増えると、検索回数が同じでもクエリ次元は増えていきます。
CPU時間・メモリ・インデックス数・データ転送(エグレス)に対する課金はありません。空のインデックスは保存次元として数えられません。
費用の目安#
公式に示されている例を挙げます。いずれも無料枠・込み分を除いた金額です。
| 規模 | 次元数 | 保存ベクトル数 | 月間クエリ数 | 月額の目安 |
|---|---|---|---|---|
| 実験 | 384 | 5,000本 | 1万回 | 無料枠に収まる |
| 小規模 | 768 | 25,000本 | 5万回 | 約0.59ドル(大部分は有料プランの込み分) |
| 本番 | 768 | 50,000本 | 20万回 | 約1.94ドル |
| 大規模 | 768 | 250,000本 | 50万回 | 約5.86ドル |
| 特大 | 1536 | 500,000本 | 100万回 | 約23.42ドル |
個人サイトや社内文書の検索であれば、多くの場合は無料枠か数ドルの範囲に収まります。ベクトルデータベースは高価という印象を持たれがちですが、この規模感は覚えておく価値があります。
主な制限#
| 項目 | 無料プラン | 有料プラン |
|---|---|---|
| インデックス数(アカウントあたり) | 100 | 50,000 |
| 1インデックスのベクトル数 | 2,000万 | 2,000万 |
| 1ベクトルの次元数 | 1,536まで | 1,536まで |
| メタデータのサイズ(1ベクトル) | 10KiB | 10KiB |
| メタデータインデックス数(1インデックス) | 10 | 10 |
| 名前空間の数(1インデックス) | 1,000 | 50,000 |
| 一括投入のバッチサイズ | Workers 1,000件 / HTTP API 5,000件 | 同左 |
| 1回のアップロードサイズ | 100MB | 100MB |
「メタデータインデックス」は、絞り込みに使うためにメタデータの項目をあらかじめ登録しておく仕組みです。1インデックスあたり10項目までなので、どの項目で絞り込むかは設計時に決めておく必要があります。
初心者が注意するポイント#
- 次元数とメトリックは後から変えられません:使う埋め込みモデルを決めてからインデックスを作ってください。モデルを乗り換えると作り直しになります
- 保存と検索で同じ埋め込みモデルを使う:違うモデルのベクトルは比較しても意味のある結果になりません
- 検索結果は「近い順」であって「正解」ではありません:関連のない内容でも、最も近ければ返ってきます。スコアの下限を決めて、低いものは捨てる作りにしてください
- メタデータの絞り込み項目は事前に決める:10項目の上限があり、後から増やすには制約があります
- クエリ次元は保存量に比例して増えます:データが10倍になれば、検索回数が同じでもクエリ次元は約10倍です
- 元の文章もどこかに保存する:Vectorizeのメタデータに全文を入れるのは10KiBの制限があります。長い本文はR2やD1に置き、Vectorizeにはその参照だけを入れる形が定番です
関連サービス#
- Workers AI:ベクトルを作る埋め込みモデルを提供する
- RAG:Vectorizeが使われる代表的な仕組み
- D1:文書の本文や属性、権限情報の保存先
- R2:元となるPDFや画像の保管場所
- Workers:Vectorizeを呼び出す実行環境
まとめ#
- Vectorizeは、Cloudflareのベクトルデータベース。2026年4月にGAとなった
- 普通のデータベースが「一致するもの」を探すのに対し、Vectorizeは「近いもの」を探す
- インデックスを作るときに、名前・次元数・距離の測り方を決める。次元数とメトリックは変更できない
- 次元数は埋め込みモデルによって決まる。上限は1,536次元。距離の測り方は迷ったら
cosine - メタデータで絞り込みと出典表示ができ、名前空間で利用者ごとに分離できる
- 料金は「次元」単位。個人・小規模用途なら無料枠か月数ドルに収まることが多い
ここまでで、RAGを自分で組み立てるための部品が揃いました。しかし、文書の変換・分割・埋め込み・保存・検索・生成を全部自分で書くのは、それなりの作業量です。次のページでは、これらをまとめて引き受けてくれるAI Searchを扱います。